
 Set up docs MCP
BigQuery 到 ClickHouse 的模板是一个批次管道,用于将 BigQuery 表中的数据摄取到 ClickHouse 表中。 该模板可以读取整个表,也可以使用提供的 SQL 查询过滤特定记录。
管道要求
- 源 BigQuery 表必须存在。
- 目标 ClickHouse 表必须存在。
- 必须能够从 Dataflow 工作节点访问 ClickHouse 主机。
Template参数
| 参数名称 | 参数说明 | 必填 | 说明 |
|---|---|---|---|
jdbcUrl |
ClickHouse JDBC URL,格式为 jdbc:clickhouse://<host>:<port>/<schema>。 |
✅ | 不要将用户名和密码作为 JDBC 选项添加。其他 JDBC 选项可附加在 JDBC URL 末尾。对于 ClickHouse Cloud 用户,请在 jdbcUrl 中添加 ssl=true&sslmode=NONE。 |
clickHouseUsername |
用于身份验证的 ClickHouse 用户名。 | ✅ | |
clickHousePassword |
用于身份验证的 ClickHouse 密码。 | ✅ | |
clickHouseTable |
用于插入数据的目标 ClickHouse 表。 | ✅ | |
maxInsertBlockSize |
插入时的最大块大小;如果插入用的块由我们控制创建,则使用此参数 (ClickHouseIO 选项) 。 | 一个 ClickHouseIO 选项。 |
|
insertDistributedSync |
如果启用此设置,写入 Distributed 表的插入查询会等待数据发送到 cluster 中的所有节点。 (ClickHouseIO 选项) 。 | 一个 ClickHouseIO 选项。 |
|
insertQuorum |
对于 Replicated 表中的 INSERT 查询,等待写入到指定数量的副本,并将数据追加线性化。0 - 禁用。 | 一个 ClickHouseIO 选项。此设置在默认服务器设置中处于禁用状态。 |
|
insertDeduplicate |
对于 Replicated 表中的 INSERT 查询,指定是否对插入块执行去重。 | 一个 ClickHouseIO 选项。 |
|
maxRetries |
每次插入的最大重试次数。 | 一个 ClickHouseIO 选项。 |
|
InputTableSpec |
要读取的 BigQuery 表。请指定 inputTableSpec 或 query 之一。如果两者都设置了,则优先使用 query 参数。示例:<BIGQUERY_PROJECT>:<DATASET_NAME>.<INPUT_TABLE>。 |
使用 BigQuery Storage Read API 直接从 BigQuery 存储中读取数据。请注意 Storage Read API 的限制。 | |
outputDeadletterTable |
用于存放未能写入输出表的消息的 BigQuery 表。如果该表不存在,则会在管道执行期间创建。如果未指定,则使用 <outputTableSpec>_error_records。例如:<PROJECT_ID>:<DATASET_NAME>.<DEADLETTER_TABLE>。 |
||
query |
用于从 BigQuery 读取数据的 SQL 查询。如果 BigQuery 数据集与 Dataflow 作业不在同一项目中,请在 SQL 查询中指定完整的数据集名称,例如:<PROJECT_ID>.<DATASET_NAME>.<TABLE_NAME>。除非 useLegacySql 为 true,否则默认使用 GoogleSQL。 |
必须指定 inputTableSpec 或 query 之一。如果同时设置这两个参数,Template将使用 query 参数。示例:SELECT * FROM sampledb.sample_table。 |
|
useLegacySql |
设为 true 以使用传统 SQL。此参数仅在使用 query 参数时适用。默认值为 false。 |
||
queryLocation |
当从授权视图读取数据且没有底层表权限时需要设置。例如,US。 |
||
queryTempDataset |
指定一个现有数据集,用于创建临时表以存储查询结果。例如,temp_dataset。 |
||
KMSEncryptionKey |
如果通过查询源从 BigQuery 读取数据,请使用此 Cloud KMS 密钥对创建的任何临时表进行加密。例如,projects/your-project/locations/global/keyRings/your-keyring/cryptoKeys/your-key。 |
源表和目标表的 schema
为了高效地将 BigQuery 数据集加载到 ClickHouse 中,管道会执行列推断过程,分为以下几个阶段:
- 模板基于目标 ClickHouse 表构建 schema 对象。
- 模板遍历 BigQuery 数据集,并尝试根据列名进行匹配。
数据类型映射
BigQuery 类型会根据你的 ClickHouse 表定义进行转换。因此,上表列出了你的目标 ClickHouse 表中建议采用的映射 (针对给定的 BigQuery 表/查询) :
| BigQuery 类型 | ClickHouse 类型 | 备注 |
|---|---|---|
| Array 类型 | Array 类型 | 内部类型必须是此表中列出的受支持基本类型之一。 |
| Boolean 类型 | Bool 类型 | |
| Date 类型 | Date 类型 | |
| Datetime 类型 | Datetime 类型 | 同样也适用于 Enum8、Enum16 和 FixedString。 |
| String 类型 | String 类型 | 在 BigQuery 中,所有 Int 类型 (INT、SMALLINT、INTEGER、BIGINT、TINYINT、BYTEINT) 都是 INT64 的别名。我们建议你在 ClickHouse 中设置合适的整数位宽,因为模板会根据已定义的列类型 (Int8、Int16、Int32、Int64) 转换该列。 |
| Numeric - Integer 类型 | Integer 类型 | 在 BigQuery 中,所有 Int 类型 (INT、SMALLINT、INTEGER、BIGINT、TINYINT、BYTEINT) 都是 INT64 的别名。我们建议你在 ClickHouse 中设置合适的整数位宽,因为模板会根据已定义的列类型 (Int8、Int16、Int32、Int64) 转换该列。如果 ClickHouse 表中使用了未明确指定的 Int 类型 (UInt8、UInt16、UInt32、UInt64) ,模板也会进行转换。 |
| Numeric - Float 类型 | Float 类型 | 支持的 ClickHouse 类型:Float32 和 Float64 |
运行Template
BigQuery 到 ClickHouse 的Template可通过 Google Cloud CLI 运行。
登录 Google Cloud Console 并搜索 DataFlow。
- 点击
CREATE JOB FROM TEMPLATE按钮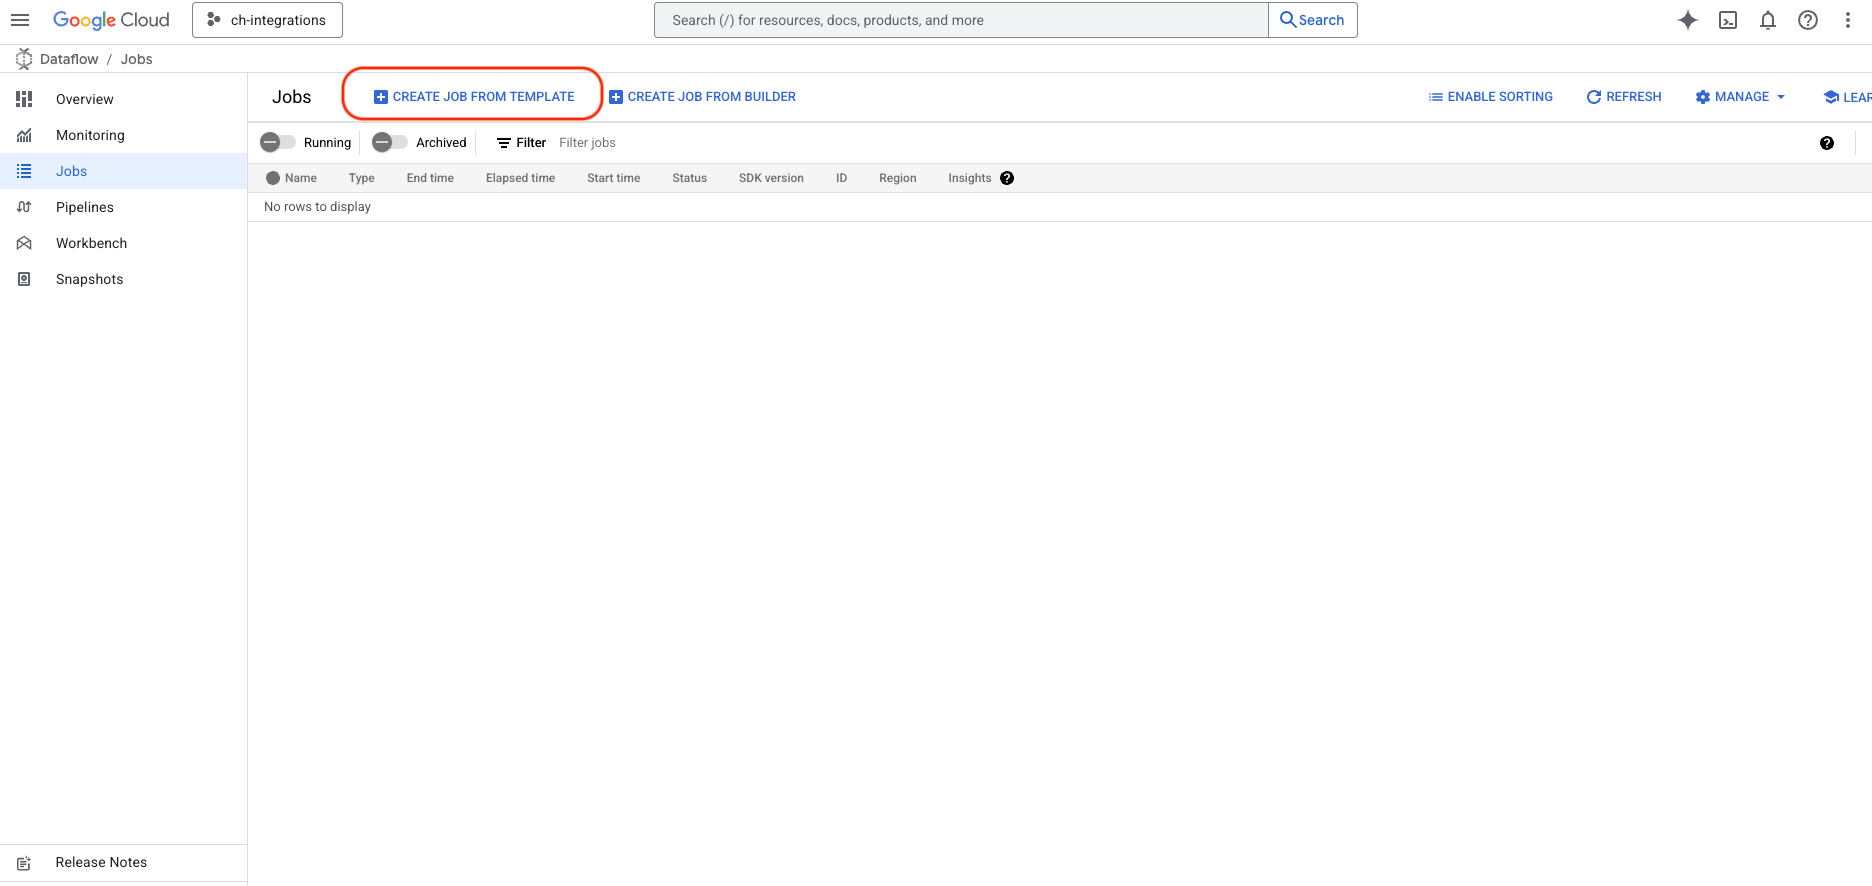
- 打开Template表单后,输入作业名称并选择所需区域。
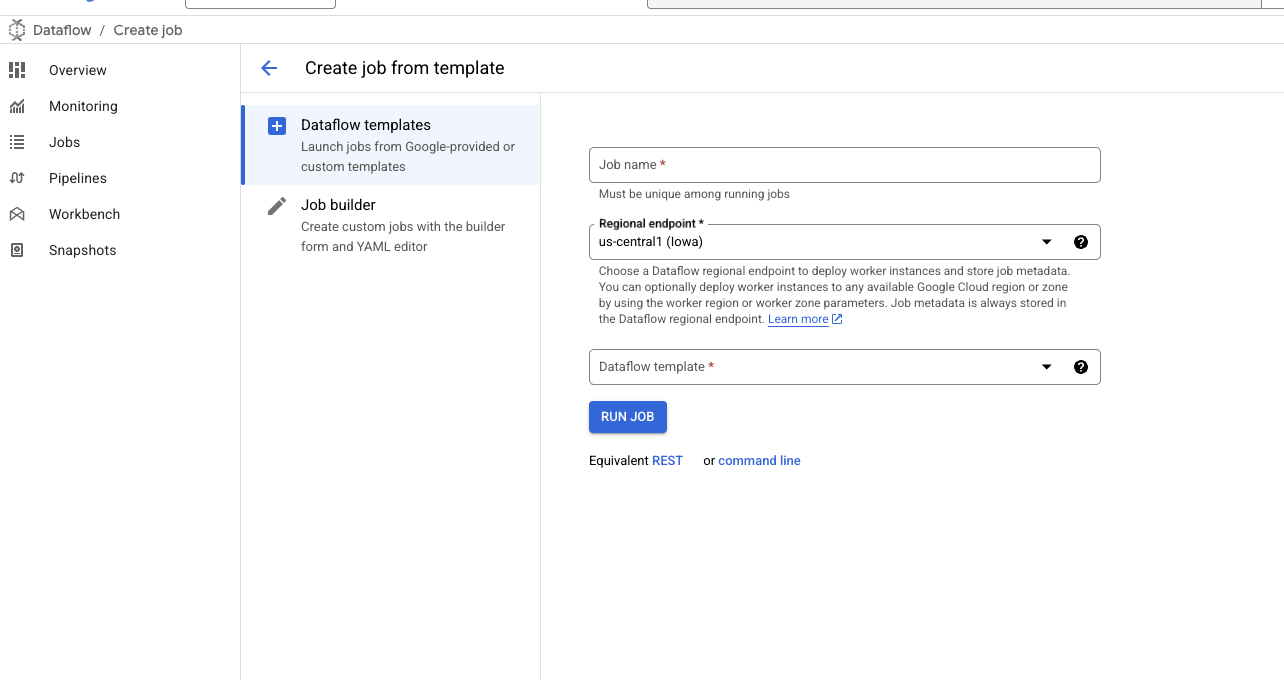
- 在
DataFlow Template输入框中,输入ClickHouse或BigQuery,然后选择BigQuery to ClickHouseTemplate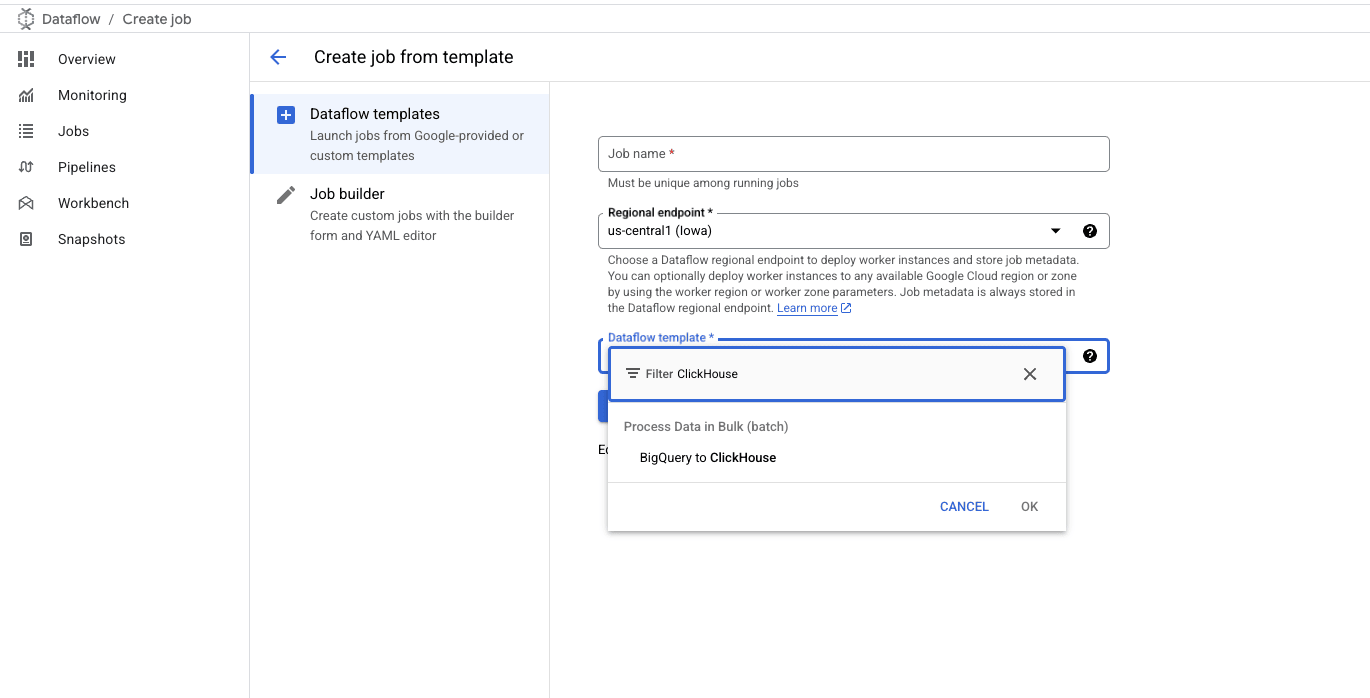
- 选中后,表单会展开,以便你填写更多详细信息:
- ClickHouse server JDBC URL,格式如下:
jdbc:clickhouse://host:port/schema。 - ClickHouse 用户名。
- ClickHouse 目标表名称。
- ClickHouse server JDBC URL,格式如下:
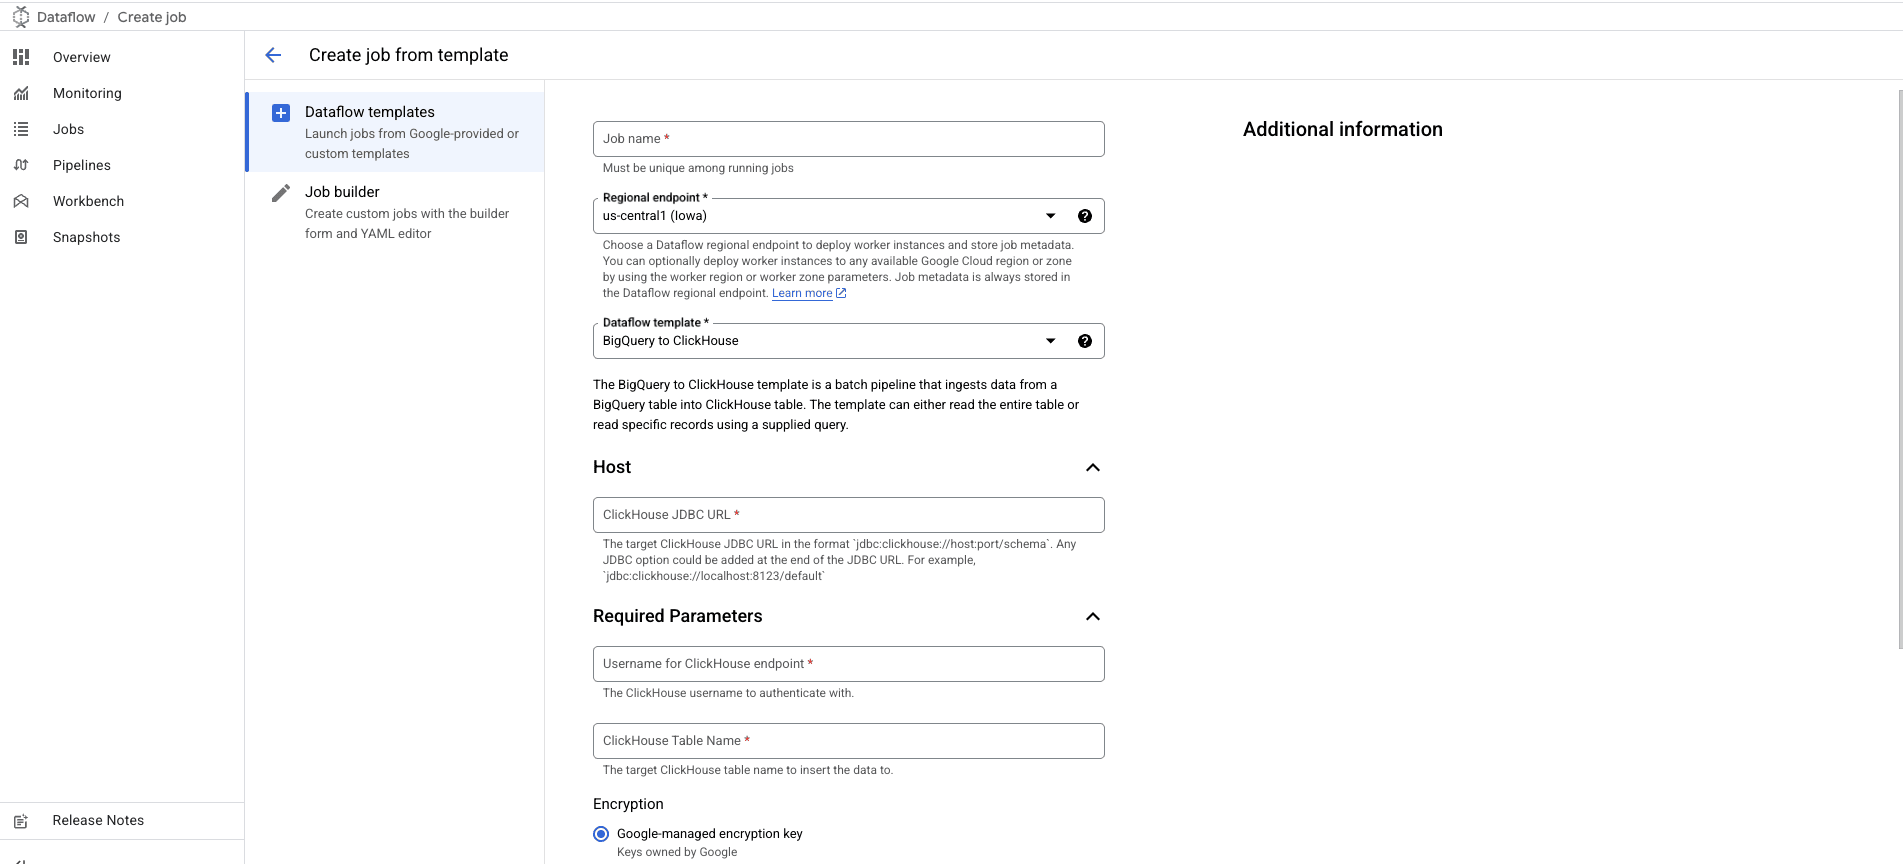
- 根据Template参数部分中的详细说明,自定义并添加任何与 BigQuery/ClickHouseIO 相关的配置
安装并配置 gcloud CLI
- 如果尚未安装,请安装
gcloudCLI。 - 按照本指南中的
Before you begin部分,设置运行 DataFlow Template所需的配置、设置和权限。
运行命令
使用 gcloud dataflow flex-template run
命令运行使用 Flex Template 的 Dataflow 作业。
下面是一个命令示例:
gcloud dataflow flex-template run "bigquery-clickhouse-dataflow-$(date +%Y%m%d-%H%M%S)" \
 --template-file-gcs-location "gs://clickhouse-dataflow-templates/bigquery-clickhouse-metadata.json" \
 --parameters inputTableSpec="<bigquery table id>",jdbcUrl="jdbc:clickhouse://<clickhouse host>:<clickhouse port>/<schema>?ssl=true&sslmode=NONE",clickHouseUsername="<username>",clickHousePassword="<password>",clickHouseTable="<clickhouse target table>"
命令说明
- 作业名称:
run关键字后面的文本是唯一的作业名称。 - Template文件:
--template-file-gcs-location指定的 JSON file 定义了Template结构以及接受的参数详情。该文件路径是公开的,可直接使用。 - 参数: 参数之间以逗号分隔。对于字符串参数,请用双引号将值括起来。
预期响应
运行命令后,你应会看到类似下面的响应:
job:
  createTime: '2025-01-26T14:34:04.608442Z'
  currentStateTime: '1970-01-01T00:00:00Z'
  id: 2025-01-26_06_34_03-13881126003586053150
  location: us-central1
  name: bigquery-clickhouse-dataflow-20250126-153400
  projectId: ch-integrations
  startTime: '2025-01-26T14:34:04.608442Z'
监控作业
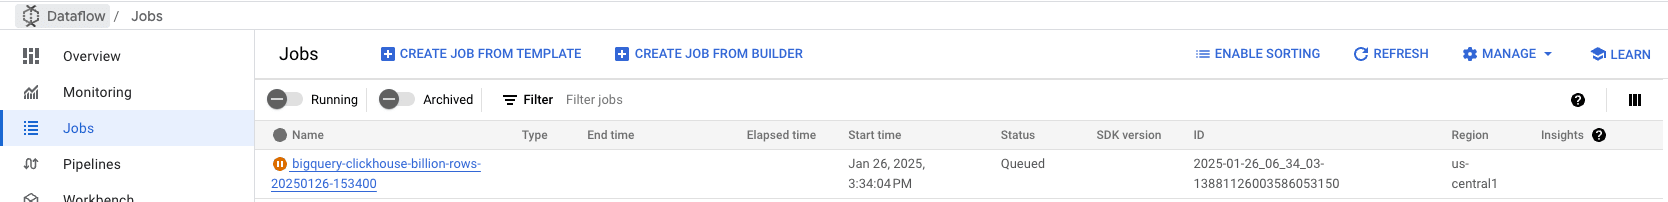
前往 Google Cloud Console 中的 Dataflow Jobs 选项卡,查看该作业的状态。你可以在这里找到作业的详细信息,包括进度以及任何错误:
故障排查
超出内存限制 (总量) 错误 (代码 241)
当 ClickHouse 在处理大批次数据时内存耗尽,就会出现此错误。要解决此问题:
- 增加实例资源:将 ClickHouse server 升级到内存更大的更高规格实例,以承载数据处理负载。
- 减小批次大小:调整 Dataflow 作业配置中的批次大小,向 ClickHouse 发送更小的数据块,从而降低每个批次的内存消耗。这些更改有助于在数据摄取期间平衡资源使用。
Template 源代码
该 Template 的源代码可在以下位置查看:
GoogleCloudPlatform/DataflowTemplates— Google Cloud Platform 的上游代码仓库。ClickHouse/DataflowTemplates— ClickHouse 的 fork。