
 Set up docs MCP
背景
インクリメンタルmaterialized view (Materialized Views) を使用すると、計算コストをクエリ時から挿入時に移せるため、SELECT クエリを高速化できます。
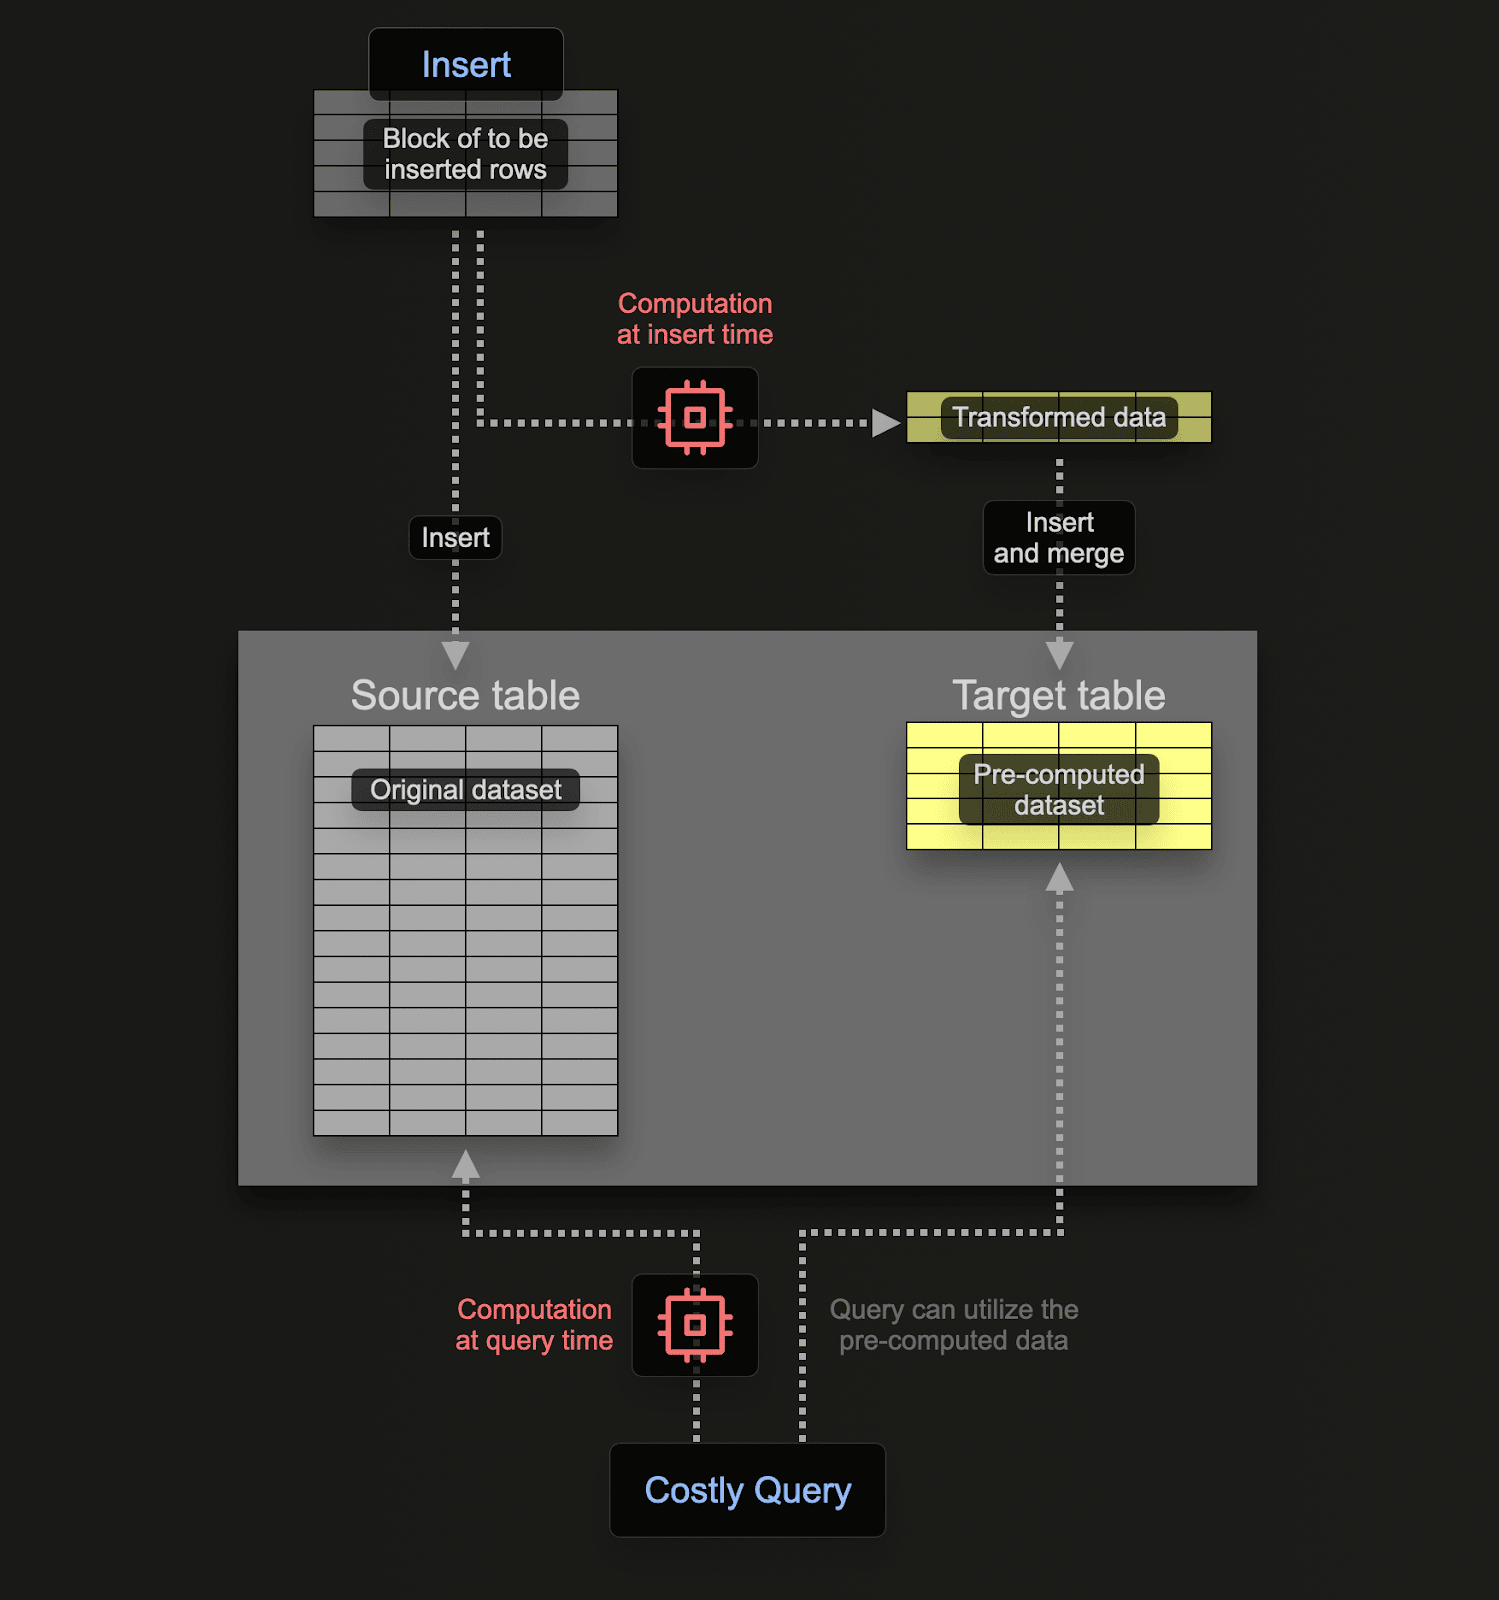
Postgres のようなトランザクションデータベースとは異なり、ClickHouse の materialized view は、データがテーブルに挿入される際に、その block に対してクエリを実行する単なるトリガーです。このクエリの結果は、2 つ目のターゲットテーブルに挿入されます。さらに行が挿入されると、結果は再びターゲットテーブルに送られ、そこで中間結果が更新・マージされます。このマージ後の結果は、元のすべてのデータに対してクエリを実行した場合と同等です。
Materialized Views の主な目的は、ターゲットテーブルに挿入される結果が、行に対する集計、フィルタリング、または変換の結果を表すことにあります。こうした結果は、多くの場合、元データをより小さく表現したものになります (集計の場合は部分的なスケッチになります) 。これに加えて、ターゲットテーブルから結果を読み取るクエリもシンプルになるため、同じ計算を元データに対して実行する場合よりもクエリ時間が短くなります。つまり、計算 (ひいてはクエリレイテンシ) をクエリ時から挿入時へ移せます。
ClickHouse の materialized view は、基になるテーブルにデータが流入するとリアルタイムで更新され、継続的に更新される索引のように機能します。これは、Materialized Views が通常、更新が必要なクエリの静的なスナップショットである他のデータベースとは対照的です (ClickHouse のリフレッシュ可能なマテリアライズドビューに似ています) 。
例
例として、「スキーマ設計」に記載されているStack Overflowデータセットを使用します。
あるポストについて、1日あたりの賛成票と反対票の数を取得する場合を考えます。
CREATE TABLE votes
(
    `Id` UInt32,
    `PostId` Int32,
    `VoteTypeId` UInt8,
    `CreationDate` DateTime64(3, 'UTC'),
    `UserId` Int32,
    `BountyAmount` UInt8
)
ENGINE = MergeTree
ORDER BY (VoteTypeId, CreationDate, PostId)

INSERT INTO votes SELECT * FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/votes/*.parquet')
0 rows in set. Elapsed: 29.359 sec. Processed 238.98 million rows, 2.13 GB (8.14 million rows/s., 72.45 MB/s.)toStartOfDay 関数を使えば、ClickHouse では比較的シンプルなクエリで実現できます。
SELECT toStartOfDay(CreationDate) AS day,
       countIf(VoteTypeId = 2) AS UpVotes,
       countIf(VoteTypeId = 3) AS DownVotes
FROM votes
GROUP BY day
ORDER BY day ASC
LIMIT 10
┌─────────────────day─┬─UpVotes─┬─DownVotes─┐
│ 2008-07-31 00:00:00 │ 6 │ 0 │
│ 2008-08-01 00:00:00 │ 182 │ 50 │
│ 2008-08-02 00:00:00 │ 436 │ 107 │
│ 2008-08-03 00:00:00 │ 564 │ 100 │
│ 2008-08-04 00:00:00 │ 1306 │ 259 │
│ 2008-08-05 00:00:00 │ 1368 │ 269 │
│ 2008-08-06 00:00:00 │ 1701 │ 211 │
│ 2008-08-07 00:00:00 │ 1544 │ 211 │
│ 2008-08-08 00:00:00 │ 1241 │ 212 │
│ 2008-08-09 00:00:00 │ 576 │ 46 │
└─────────────────────┴─────────┴───────────┘
10 rows in set. Elapsed: 0.133 sec. Processed 238.98 million rows, 2.15 GB (1.79 billion rows/s., 16.14 GB/s.)
Peak memory usage: 363.22 MiB.このクエリはClickHouseのおかげですでに高速ですが、さらに改善できるでしょうか?
materialized viewを使用してinsert時にこれをコンピュートする場合、結果を受け取るテーブルが必要です。このテーブルは1日あたり1行のみを保持する必要があります。既存の日付に対して更新を受信した場合、他のカラムは既存の日付の行にマージされる必要があります。このインクリメンタルな状態のマージを行うには、他のカラムの部分的な状態を保存しておく必要があります。
これにはClickHouseの特殊なエンジンタイプが必要です: SummingMergeTree。これは、同じordering keyを持つすべての行を、数値カラムの合計値を含む1行に置き換えます。次のテーブルは、同じ日付を持つ行をマージし、すべての数値カラムの値を合計します:
CREATE TABLE up_down_votes_per_day
(
  `Day` Date,
  `UpVotes` UInt32,
  `DownVotes` UInt32
)
ENGINE = SummingMergeTree
ORDER BY Day
materialized viewの動作を確認するために、votesテーブルが空でまだデータが存在しない状態を想定します。materialized viewは、votesに挿入されたデータに対して上記のSELECTを実行し、その結果をup_down_votes_per_dayに送信します。
CREATE MATERIALIZED VIEW up_down_votes_per_day_mv TO up_down_votes_per_day AS
SELECT toStartOfDay(CreationDate)::Date AS Day,
       countIf(VoteTypeId = 2) AS UpVotes,
       countIf(VoteTypeId = 3) AS DownVotes
FROM votes
GROUP BY Day
ここでの TO 句が重要で、結果の送信先 (つまり up_down_votes_per_day) を指定します。
先ほどの insert を使って、Votes テーブルに再度データを投入できます:
INSERT INTO votes SELECT toUInt32(Id) AS Id, toInt32(PostId) AS PostId, VoteTypeId, CreationDate, UserId, BountyAmount
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/votes/*.parquet')
0 rows in set. Elapsed: 111.964 sec. Processed 477.97 million rows, 3.89 GB (4.27 million rows/s., 34.71 MB/s.)
Peak memory usage: 283.49 MiB.完了したら、up_down_votes_per_day のサイズを確認しましょう。1 日につき 1 行になっているはずです。
SELECT count()
FROM up_down_votes_per_day
FINAL
┌─count()─┐
│ 5723 │
└─────────┘ここでは、クエリの結果を保存することで、行数を 2 億 3800 万 (votes) から 5000 まで実質的に減らしています。ただし重要なのは、新しい投票が votes テーブルに挿入されると、その日の新しい値が up_down_votes_per_day に送られ、そこでバックグラウンドで非同期に自動的にマージされ、1 日あたり 1 行だけが保持されるという点です。したがって、up_down_votes_per_day は常に小さく、かつ最新の状態に保たれます。
行のマージは非同期で行われるため、ユーザーがクエリを実行した時点では、1 日あたり複数の行が存在する可能性があります。未処理の行がクエリ時に確実にマージされるようにするには、2 つの方法があります。
- テーブル名に
FINALmodifier を使用します。上の count クエリではこの方法を使いました。 - 最終テーブルで使用しているソートキー、つまり
CreationDateで集約し、メトリクスを合計します。通常はこちらの方が効率的で柔軟です (テーブルをほかの用途にも使えるため) が、クエリによっては前者の方がシンプルな場合もあります。以下では両方を示します。
SELECT
        Day,
        UpVotes,
        DownVotes
FROM up_down_votes_per_day
FINAL
ORDER BY Day ASC
LIMIT 10
10 rows in set. Elapsed: 0.004 sec. Processed 8.97 thousand rows, 89.68 KB (2.09 million rows/s., 20.89 MB/s.)
Peak memory usage: 289.75 KiB.SELECT Day, sum(UpVotes) AS UpVotes, sum(DownVotes) AS DownVotes
FROM up_down_votes_per_day
GROUP BY Day
ORDER BY Day ASC
LIMIT 10┌────────Day─┬─UpVotes─┬─DownVotes─┐
│ 2008-07-31 │ 6 │ 0 │
│ 2008-08-01 │ 182 │ 50 │
│ 2008-08-02 │ 436 │ 107 │
│ 2008-08-03 │ 564 │ 100 │
│ 2008-08-04 │ 1306 │ 259 │
│ 2008-08-05 │ 1368 │ 269 │
│ 2008-08-06 │ 1701 │ 211 │
│ 2008-08-07 │ 1544 │ 211 │
│ 2008-08-08 │ 1241 │ 212 │
│ 2008-08-09 │ 576 │ 46 │
└────────────┴─────────┴───────────┘
10 rows in set. Elapsed: 0.010 sec. Processed 8.97 thousand rows, 89.68 KB (907.32 thousand rows/s., 9.07 MB/s.)
Peak memory usage: 567.61 KiB.これにより、クエリは 0.133 秒から 0.004 秒へと高速化され、25 倍以上の改善となりました!
より複雑な例
上記の例では、Materialized Views を使って、日ごとに 2 つの合計値を計算し、それを維持しています。合計値は、部分状態を維持する集計の中で最も単純な形式です。新しい値が到着したら、既存の値に加えるだけでよいためです。ただし、ClickHouse の Materialized Views は、あらゆる種類の集計に使用できます。
各日の投稿について、いくつかの統計を計算したいとします。たとえば、Score の 99.9 パーセンタイルと、CommentCount の平均です。これを計算するクエリは、次のようになります。
SELECT
        toStartOfDay(CreationDate) AS Day,
        quantile(0.999)(Score) AS Score_99th,
        avg(CommentCount) AS AvgCommentCount
FROM posts
GROUP BY Day
ORDER BY Day DESC
LIMIT 10
┌─────────────────Day─┬────────Score_99th─┬────AvgCommentCount─┐
│ 2024-03-31 00:00:00 │ 5.23700000000008 │ 1.3429811866859624 │
│ 2024-03-30 00:00:00 │ 5 │ 1.3097158891616976 │
│ 2024-03-29 00:00:00 │ 5.78899999999976 │ 1.2827635327635327 │
│ 2024-03-28 00:00:00 │ 7 │ 1.277746158224246 │
│ 2024-03-27 00:00:00 │ 5.738999999999578 │ 1.2113264918282023 │
│ 2024-03-26 00:00:00 │ 6 │ 1.3097536945812809 │
│ 2024-03-25 00:00:00 │ 6 │ 1.2836721018539201 │
│ 2024-03-24 00:00:00 │ 5.278999999999996 │ 1.2931667891256429 │
│ 2024-03-23 00:00:00 │ 6.253000000000156 │ 1.334061135371179 │
│ 2024-03-22 00:00:00 │ 9.310999999999694 │ 1.2388059701492538 │
└─────────────────────┴───────────────────┴────────────────────┘
10 rows in set. Elapsed: 0.113 sec. Processed 59.82 million rows, 777.65 MB (528.48 million rows/s., 6.87 GB/s.)
Peak memory usage: 658.84 MiB.前と同様に、新しい投稿が posts テーブルに挿入されるたびに、上記のクエリを実行する materialized view を作成できます。
ここでは例として、また posts データを S3 から読み込まないようにするため、posts と同じスキーマを持つ複製テーブル posts_null を作成します。ただし、このテーブル自体にはデータは保存されず、行が挿入されたときに materialized view が利用するためだけに使われます。データが保存されないようにするには、Null テーブルエンジン を使用できます。
CREATE TABLE posts_null AS posts ENGINE = NullNull table engine は強力な最適化手法です。/dev/null のようなものだと考えてください。materialized view は、posts_null テーブルが insert 時に行を受け取ると、要約統計を計算して保存します。つまり、これは単なるトリガーです。ただし、生データは保存されません。今回のケースではおそらく元の posts も保存したいところですが、この方法を使えば、生データの保存オーバーヘッドを避けながら集計を計算できます。
したがって、materialized view は次のようになります。
CREATE MATERIALIZED VIEW post_stats_mv TO post_stats_per_day AS
       SELECT toStartOfDay(CreationDate) AS Day,
       quantileState(0.999)(Score) AS Score_quantiles,
       avgState(CommentCount) AS AvgCommentCount
FROM posts_null
GROUP BY Day
集約関数の末尾に接尾辞 State を付けていることに注目してください。これにより、最終結果ではなく、その関数の集約状態が返されます。これには、この部分状態をほかの状態とマージするための追加情報が含まれます。たとえば平均値の場合、そのカラムの件数と合計が含まれます。
正しい結果を得るには、部分集約状態が必要です。たとえば平均値を計算する場合、単に各部分範囲の平均をさらに平均しても、正しい結果にはなりません。
次に、このビュー post_stats_per_day のターゲットテーブルを作成します。このテーブルには、これらの部分集約状態が格納されます:
CREATE TABLE post_stats_per_day
(
  `Day` Date,
  `Score_quantiles` AggregateFunction(quantile(0.999), Int32),
  `AvgCommentCount` AggregateFunction(avg, UInt8)
)
ENGINE = AggregatingMergeTree
ORDER BY Day
先ほどまでは、件数を保存するには SummingMergeTree で十分でしたが、他の関数では、より高度なエンジン型である AggregatingMergeTree が必要です。
ClickHouse に集約状態が保存されることを認識させるため、Score_quantiles と AvgCommentCount を型 AggregateFunction として定義し、部分状態の関数ソースと、その元になるカラムの型を指定します。SummingMergeTree と同様に、同じ ORDER BY キー値を持つ行はマージされます (上記の例では Day) 。
materialized view を介して post_stats_per_day にデータを投入するには、posts のすべての行を posts_null に挿入するだけです。
INSERT INTO posts_null SELECT * FROM posts0 rows in set. Elapsed: 13.329 sec. Processed 119.64 million rows, 76.99 GB (8.98 million rows/s., 5.78 GB/s.)本番環境では、materialized view は
postsテーブルにアタッチするのが一般的です。ここでは、Nullテーブルを示すためにposts_nullを使用しています。
最終的なクエリでは、関数に Merge 接尾辞を使用する必要があります (カラムには部分集約状態が格納されているためです) :
SELECT
        Day,
        quantileMerge(0.999)(Score_quantiles),
        avgMerge(AvgCommentCount)
FROM post_stats_per_day
GROUP BY Day
ORDER BY Day DESC
LIMIT 10ここでは、FINAL の代わりに GROUP BY を使用している点に注意してください。
その他の用途
ここまでは主に、materialized view を使ってデータの部分集約を増分更新し、計算をクエリ時から挿入時へ移す方法に焦点を当ててきました。この一般的なユースケース以外にも、materialized view にはさまざまな用途があります。
フィルタリングと変換
状況によっては、INSERT 時に行やカラムの一部だけを挿入したいことがあります。この場合、posts_null テーブルで INSERT を受け取り、SELECT クエリで行をフィルタリングしてから posts テーブルに挿入できます。たとえば、posts テーブルの Tags カラムを変換したいとします。このカラムには、タグ名がパイプ区切りのリストとして格納されています。これを配列に変換することで、個々のタグの値ごとに集計しやすくなります。
この変換は、
INSERT INTO SELECTの実行時に行うこともできます。materialized view を使えば、このロジックを ClickHouse の DDL にカプセル化し、INSERTをシンプルに保ったまま、新しく追加されるすべての行に変換を適用できます。
この変換のための materialized view を以下に示します。
CREATE MATERIALIZED VIEW posts_mv TO posts AS
        SELECT * EXCEPT Tags, arrayFilter(t -> (t != ''), splitByChar('|', Tags)) as Tags FROM posts_null
ルックアップテーブル
ClickHouse のソートキーを選ぶ際には、アクセスパターンを考慮する必要があります。よくフィルタ句や集約句で使用されるカラムを選ぶべきです。ただし、単一のカラムの組み合わせでは表しきれない、より多様なアクセスパターンをユーザーが持つケースでは、これが制約になることがあります。たとえば、次の comments テーブルを考えてみましょう。
CREATE TABLE comments
(
    `Id` UInt32,
    `PostId` UInt32,
    `Score` UInt16,
    `Text` String,
    `CreationDate` DateTime64(3, 'UTC'),
    `UserId` Int32,
    `UserDisplayName` LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY PostId
0 rows in set. Elapsed: 46.357 sec. Processed 90.38 million rows, 11.14 GB (1.95 million rows/s., 240.22 MB/s.)ここでのソートキーにより、PostId で絞り込むクエリ向けにテーブルが最適化されます。
たとえば、特定の UserId で絞り込み、その平均 Score を計算したい場合を考えます:
SELECT avg(Score)
FROM comments
WHERE UserId = 8592047
┌──────────avg(Score)─┐
│ 0.18181818181818182 │
└─────────────────────┘
1 row in set. Elapsed: 0.778 sec. Processed 90.38 million rows, 361.59 MB (116.16 million rows/s., 464.74 MB/s.)
Peak memory usage: 217.08 MiB.高速ではありますが (ClickHouse にとってはデータ量が小さいため) 、処理された行数が 9,038 万であることから、これはテーブル全体のスキャンを必要としていることがわかります。より大きなデータセットでは、materialized view を使って、フィルタ用カラム UserId に対するソートキー値 PostId をルックアップできます。これらの値を使うことで、効率的なルックアップを実行できます。
この例では、materialized view は非常にシンプルで、INSERT 時に comments から PostId と UserId だけを選択します。これらの結果は、さらに UserId で順序付けされた comments_posts_users テーブルに送られます。以下では、Comments テーブルの null 版を作成し、これを使って view と comments_posts_users テーブルにデータを投入します。
CREATE TABLE comments_posts_users (
  PostId UInt32,
  UserId Int32
) ENGINE = MergeTree ORDER BY UserId

CREATE TABLE comments_null AS comments
ENGINE = Null

CREATE MATERIALIZED VIEW comments_posts_users_mv TO comments_posts_users AS
SELECT PostId, UserId FROM comments_null

INSERT INTO comments_null SELECT * FROM comments
0 rows in set. Elapsed: 5.163 sec. Processed 90.38 million rows, 17.25 GB (17.51 million rows/s., 3.34 GB/s.)これで、このビューをサブクエリ内で使用して、先ほどのクエリを高速化できます。
SELECT avg(Score)
FROM comments
WHERE PostId IN (
        SELECT PostId
        FROM comments_posts_users
        WHERE UserId = 8592047
) AND UserId = 8592047
┌──────────avg(Score)─┐
│ 0.18181818181818182 │
└─────────────────────┘
1 row in set. Elapsed: 0.012 sec. Processed 88.61 thousand rows, 771.37 KB (7.09 million rows/s., 61.73 MB/s.)materialized view の連鎖 / カスケード
materialized view は連鎖 (またはカスケード) できるため、複雑なワークフローを構築できます。 詳細については、ガイド「materialized view のカスケード」を参照してください。
materialized view と JOIN
ClickHouse のインクリメンタルmaterialized view は JOIN 操作を完全にサポートしていますが、重要な制約が 1 つあります。materialized view がトリガーされるのは、ソーステーブル (クエリ内で最も左にあるテーブル) への insert 時だけです。 JOIN の右側のテーブルは、データが変更されても更新のトリガーにはなりません。この挙動は、挿入時にデータを集計または変換する インクリメンタルmaterialized view を構築する場合に特に重要です。
インクリメンタルmaterialized view を JOIN を使って定義した場合、SELECT クエリ内で最も左にあるテーブルがソースとして機能します。このテーブルに新しい行が挿入されると、ClickHouse はその新たに挿入された行に対してのみ materialized view クエリを実行します。JOIN の右側のテーブルはこの実行時に全件読み取られますが、それらの変更だけではビューはトリガーされません。
この挙動により、Materialized Views における JOIN は、静的なディメンションデータに対するスナップショット join に近いものになります。
これは、参照テーブルやディメンションテーブルでデータを enrich する用途ではうまく機能します。ただし、右側のテーブル (たとえばユーザーメタデータ) に対する更新は、materialized view にはさかのぼって反映されません。更新後のデータを反映させるには、ソーステーブルに新たな insert が必要です。
例
Stack Overflow データセットを使って、具体的な例を見ていきましょう。materialized view を使用して、users テーブルのユーザー表示名を含むユーザーごとの日次バッジ数を計算します。
念のため再掲すると、テーブルのスキーマは次のとおりです。
CREATE TABLE badges
(
    `Id` UInt32,
    `UserId` Int32,
    `Name` LowCardinality(String),
    `Date` DateTime64(3, 'UTC'),
    `Class` Enum8('Gold' = 1, 'Silver' = 2, 'Bronze' = 3),
    `TagBased` Bool
)
ENGINE = MergeTree
ORDER BY UserId

CREATE TABLE users
(
    `Id` Int32,
    `Reputation` UInt32,
    `CreationDate` DateTime64(3, 'UTC'),
    `DisplayName` LowCardinality(String),
    `LastAccessDate` DateTime64(3, 'UTC'),
    `Location` LowCardinality(String),
    `Views` UInt32,
    `UpVotes` UInt32,
    `DownVotes` UInt32
)
ENGINE = MergeTree
ORDER BY Id;
users テーブルには、あらかじめデータが投入されているものとします。
INSERT INTO users
SELECT * FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/users.parquet');
materialized view と、それに対応するターゲットテーブルは次のように定義されます。
CREATE TABLE daily_badges_by_user
(
    Day Date,
    UserId Int32,
    DisplayName LowCardinality(String),
    Gold UInt32,
    Silver UInt32,
    Bronze UInt32
)
ENGINE = SummingMergeTree
ORDER BY (DisplayName, UserId, Day);

CREATE MATERIALIZED VIEW daily_badges_by_user_mv TO daily_badges_by_user AS
SELECT
    toDate(Date) AS Day,
    b.UserId,
    u.DisplayName,
    countIf(Class = 'Gold') AS Gold,
    countIf(Class = 'Silver') AS Silver,
    countIf(Class = 'Bronze') AS Bronze
FROM badges AS b
LEFT JOIN users AS u ON b.UserId = u.Id
GROUP BY Day, b.UserId, u.DisplayName;ここで badges テーブルにデータを投入すると、ビューがトリガーされ、daily_badges_by_user テーブルにデータが投入されます。
INSERT INTO badges SELECT *
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/badges.parquet')
0 rows in set. Elapsed: 433.762 sec. Processed 1.16 billion rows, 28.50 GB (2.67 million rows/s., 65.70 MB/s.)特定のユーザーが獲得したバッジを確認するには、次のクエリを記述できます。
SELECT *
FROM daily_badges_by_user
FINAL
WHERE DisplayName = 'gingerwizard'
┌────────Day─┬──UserId─┬─DisplayName──┬─Gold─┬─Silver─┬─Bronze─┐
│ 2023-02-27 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-02-28 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2013-10-30 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2024-03-04 │ 2936484 │ gingerwizard │ 0 │ 1 │ 0 │
│ 2024-03-05 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-04-17 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2013-11-18 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-10-31 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
└────────────┴─────────┴──────────────┴──────┴────────┴────────┘
8 rows in set. Elapsed: 0.018 sec. Processed 32.77 thousand rows, 642.14 KB (1.86 million rows/s., 36.44 MB/s.)このユーザーが新しいバッジを受け取り、新しい行が挿入されると、ビューが更新されます。
INSERT INTO badges VALUES (53505058, 2936484, 'gingerwizard', now(), 'Gold', 0);1 row in set. Elapsed: 7.517 sec.SELECT *
FROM daily_badges_by_user
FINAL
WHERE DisplayName = 'gingerwizard'┌────────Day─┬──UserId─┬─DisplayName──┬─Gold─┬─Silver─┬─Bronze─┐
│ 2013-10-30 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2013-11-18 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-02-27 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-02-28 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-04-17 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2023-10-31 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2024-03-04 │ 2936484 │ gingerwizard │ 0 │ 1 │ 0 │
│ 2024-03-05 │ 2936484 │ gingerwizard │ 0 │ 0 │ 1 │
│ 2025-04-13 │ 2936484 │ gingerwizard │ 1 │ 0 │ 0 │
└────────────┴─────────┴──────────────┴──────┴────────┴────────┘
9 rows in set. Elapsed: 0.017 sec. Processed 32.77 thousand rows, 642.27 KB (1.96 million rows/s., 38.50 MB/s.)一方、新しいユーザーのバッジを先に insert し、その後でそのユーザーの行を insert すると、materialized view はそのユーザーのメトリクスを取り込めません。
INSERT INTO badges VALUES (53505059, 23923286, 'Good Answer', now(), 'Bronze', 0);
INSERT INTO users VALUES (23923286, 1, now(),  'brand_new_user', now(), 'UK', 1, 1, 0);
SELECT *
FROM daily_badges_by_user
FINAL
WHERE DisplayName = 'brand_new_user';0 rows in set. Elapsed: 0.017 sec. Processed 32.77 thousand rows, 644.32 KB (1.98 million rows/s., 38.94 MB/s.)この場合、このビューが実行されるのは、ユーザーの行がまだ存在しない最初のバッジの insert 時のみです。ユーザーに別のバッジを insert すると、想定どおり行が挿入されます。
INSERT INTO badges VALUES (53505060, 23923286, 'Teacher', now(), 'Bronze', 0);

SELECT *
FROM daily_badges_by_user
FINAL
WHERE DisplayName = 'brand_new_user'
┌────────Day─┬───UserId─┬─DisplayName────┬─Gold─┬─Silver─┬─Bronze─┐
│ 2025-04-13 │ 23923286 │ brand_new_user │ 0 │ 0 │ 1 │
└────────────┴──────────┴────────────────┴──────┴────────┴────────┘
1 row in set. Elapsed: 0.018 sec. Processed 32.77 thousand rows, 644.48 KB (1.87 million rows/s., 36.72 MB/s.)ただし、この結果は誤りです。
materialized view における JOIN のベストプラクティス
-
一番左のテーブルをトリガーとして使用します。 materialized view をトリガーするのは、
SELECTステートメントの左側にあるテーブルだけです。右側のテーブルへの変更では更新はトリガーされません。 -
JOIN するデータは事前に挿入しておきます。 ソーステーブルに行を挿入する前に、JOIN 対象のテーブルにデータが存在していることを確認してください。JOIN は挿入時に評価されるため、データが欠けていると一致しない行や NULL が発生します。
-
JOIN で取得するカラムを制限します。 メモリ使用量を最小限に抑え、挿入時のレイテンシを減らすために、JOIN 対象のテーブルからは必要なカラムだけを選択してください (以下を参照) 。
-
挿入時のパフォーマンスを評価します。 JOIN は挿入のコストを増加させます。特に右側のテーブルが大きい場合に顕著です。本番相当の代表的なデータを使用して挿入レートをベンチマークしてください。
-
単純なルックアップには Dictionaries を優先します。高コストな JOIN 演算を避けるため、キー・バリューのルックアップ (例: ユーザー ID から名前) には Dictionaries を使用してください。
-
マージ効率のために
GROUP BYとORDER BYを揃えます。SummingMergeTreeまたはAggregatingMergeTreeを使用する場合は、効率的に行をマージできるよう、GROUP BYがターゲットテーブルのORDER BY句と一致していることを確認してください。 -
明示的なカラムの別名を使用します。 テーブル間で同名のカラムがある場合は、あいまいさを防ぎ、ターゲットテーブルで正しい結果を得られるように、別名を使用してください。
-
挿入量と頻度を考慮します。 JOIN は中程度の挿入ワークロードでは有効に機能します。高スループットのインジェストでは、ステージングテーブル、事前 JOIN、または Dictionaries や リフレッシュ可能なマテリアライズドビュー などの他の方法の使用を検討してください。
フィルターと join でソーステーブルを使用する
ClickHouse で materialized view を扱う際は、materialized view のクエリ実行時にソーステーブルがどのように扱われるかを理解しておくことが重要です。具体的には、materialized view のクエリ内のソーステーブルは、挿入されたデータの block に置き換えられます。この挙動を正しく理解していないと、予期しない結果になることがあります。
例となるシナリオ
次の構成を考えてみましょう。
CREATE TABLE t0 (`c0` Int) ENGINE = Memory;
CREATE TABLE mvw1_inner (`c0` Int) ENGINE = Memory;
CREATE TABLE mvw2_inner (`c0` Int) ENGINE = Memory;

CREATE VIEW vt0 AS SELECT * FROM t0;

CREATE MATERIALIZED VIEW mvw1 TO mvw1_inner
AS SELECT count(*) AS c0
    FROM t0
    LEFT JOIN ( SELECT * FROM t0 ) AS x ON t0.c0 = x.c0;

CREATE MATERIALIZED VIEW mvw2 TO mvw2_inner
AS SELECT count(*) AS c0
    FROM t0
    LEFT JOIN vt0 ON t0.c0 = vt0.c0;

INSERT INTO t0 VALUES (1),(2),(3);

INSERT INTO t0 VALUES (1),(2),(3),(4),(5);

SELECT * FROM mvw1;
┌─c0─┐
│ 3 │
│ 5 │
└────┘SELECT * FROM mvw2;┌─c0─┐
│ 3 │
│ 8 │
└────┘説明
上記の例では、2 つの materialized view mvw1 と mvw2 があり、どちらも似た処理を行いますが、ソーステーブル t0 の参照方法にわずかな違いがあります。
mvw1 では、テーブル t0 は JOIN の右側にある (SELECT * FROM t0) サブクエリ内で直接参照されています。t0 にデータが insert されると、materialized view のクエリは、t0 が挿入されたデータの block に置き換えられた状態で実行されます。つまり、JOIN 演算はテーブル全体ではなく、新たに挿入された行に対してのみ実行されます。
2 つ目の vt0 を join するケースでは、ビューは t0 からすべてのデータを読み取ります。これにより、JOIN 演算では新たに挿入された block だけでなく、t0 内のすべての行が考慮されます。
重要な違いは、ClickHouse が materialized view のクエリ内でソーステーブルをどのように扱うかにあります。materialized view が insert によってトリガーされると、ソーステーブル (この場合は t0) は挿入されたデータの block に置き換えられます。この挙動はクエリの最適化に活用できますが、意図しない結果を避けるため、注意して扱う必要があります。
ユースケースと注意点
実際には、この挙動を利用して、ソーステーブル内のデータの一部だけを処理すればよい materialized view を最適化できます。たとえば、サブクエリを使ってソーステーブルを他のテーブルと結合する前に絞り込むことができます。これにより、materialized view で処理するデータ量を減らし、パフォーマンスを向上させることができます。
CREATE TABLE t0 (id UInt32, value String) ENGINE = MergeTree() ORDER BY id;
CREATE TABLE t1 (id UInt32, description String) ENGINE = MergeTree() ORDER BY id;
INSERT INTO t1 VALUES (1, 'A'), (2, 'B'), (3, 'C');

CREATE TABLE mvw1_target_table (id UInt32, value String, description String) ENGINE = MergeTree() ORDER BY id;

CREATE MATERIALIZED VIEW mvw1 TO mvw1_target_table AS
SELECT t0.id, t0.value, t1.description
FROM t0
JOIN (SELECT * FROM t1 WHERE t1.id IN (SELECT id FROM t0)) AS t1
ON t0.id = t1.id;この例では、IN (SELECT id FROM t0) サブクエリから作成される集合には新たに挿入された行だけが含まれるため、それを使って t1 を絞り込むことができます。
Stack Overflow を使った例
users table のユーザー表示名も含めて、ユーザーごとの 1 日あたりの badges 数を計算する先ほどの materialized view の例を見てみましょう。
CREATE MATERIALIZED VIEW daily_badges_by_user_mv TO daily_badges_by_user
AS SELECT
    toDate(Date) AS Day,
    b.UserId,
    u.DisplayName,
    countIf(Class = 'Gold') AS Gold,
    countIf(Class = 'Silver') AS Silver,
    countIf(Class = 'Bronze') AS Bronze
FROM badges AS b
LEFT JOIN users AS u ON b.UserId = u.Id
GROUP BY Day, b.UserId, u.DisplayName;このビューは、badges テーブルへの insert レイテンシに大きな影響を及ぼしました。例えば、
INSERT INTO badges VALUES (53505058, 2936484, 'gingerwizard', now(), 'Gold', 0);1 row in set. Elapsed: 7.517 sec.上記の方法を使えば、このビューを最適化できます。挿入されたバッジ行のユーザー ID を使って、users テーブルに絞り込み条件を追加します:
CREATE MATERIALIZED VIEW daily_badges_by_user_mv TO daily_badges_by_user
AS SELECT
    toDate(Date) AS Day,
    b.UserId,
    u.DisplayName,
    countIf(Class = 'Gold') AS Gold,
    countIf(Class = 'Silver') AS Silver,
    countIf(Class = 'Bronze') AS Bronze
FROM badges AS b
LEFT JOIN
(
    SELECT
        Id,
        DisplayName
    FROM users
    WHERE Id IN (
        SELECT UserId
        FROM badges
    )
) AS u ON b.UserId = u.Id
GROUP BY
    Day,
    b.UserId,
    u.DisplayName
これにより、badges の初回挿入が高速化されるだけでなく:
INSERT INTO badges SELECT *
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/badges.parquet')
0 rows in set. Elapsed: 132.118 sec. Processed 323.43 million rows, 4.69 GB (2.45 million rows/s., 35.49 MB/s.)
Peak memory usage: 1.99 GiB.また、これにより今後のbadge insertも効率的になります:
INSERT INTO badges VALUES (53505058, 2936484, 'gingerwizard', now(), 'Gold', 0);1 row in set. Elapsed: 0.583 sec.上記の操作では、ユーザー ID 2936484 について、users テーブルからは 1 行だけが取得されます。このルックアップも、テーブルのソートキー Id によって最適化されます。
materialized view とユニオン
UNION ALL クエリは、複数のソーステーブルのデータを 1 つの結果セットにまとめるためによく使われます。
UNION ALL はインクリメンタルmaterialized view では直接サポートされていませんが、SELECT の各分岐ごとに個別の materialized view を作成し、その結果を共通のターゲットテーブルに書き込むことで、同じことを実現できます。
この例では、Stack Overflow データセットを使用します。以下の badges テーブルと comments テーブルは、それぞれユーザーが獲得したバッジと、投稿に付けたコメントを表しています。
CREATE TABLE stackoverflow.comments
(
    `Id` UInt32,
    `PostId` UInt32,
    `Score` UInt16,
    `Text` String,
    `CreationDate` DateTime64(3, 'UTC'),
    `UserId` Int32,
    `UserDisplayName` LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY CreationDate

CREATE TABLE stackoverflow.badges
(
    `Id` UInt32,
    `UserId` Int32,
    `Name` LowCardinality(String),
    `Date` DateTime64(3, 'UTC'),
    `Class` Enum8('Gold' = 1, 'Silver' = 2, 'Bronze' = 3),
    `TagBased` Bool
)
ENGINE = MergeTree
ORDER BY UserId
これらには、次の INSERT INTO コマンドでデータを挿入できます。
INSERT INTO stackoverflow.badges SELECT *
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/badges.parquet')
INSERT INTO stackoverflow.comments SELECT *
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/comments/*.parquet')
これら2つのテーブルを結合して、各ユーザーの最新のアクティビティを表示する、ユーザーアクティビティの統合ビューを作成するとします。
SELECT
 UserId,
 argMax(description, event_time) AS last_description,
 argMax(activity_type, event_time) AS activity_type,
    max(event_time) AS last_activity
FROM
(
    SELECT
 UserId,
 CreationDate AS event_time,
        Text AS description,
        'comment' AS activity_type
    FROM stackoverflow.comments
    UNION ALL
    SELECT
 UserId,
        Date AS event_time,
        Name AS description,
        'badge' AS activity_type
    FROM stackoverflow.badges
)
GROUP BY UserId
ORDER BY last_activity DESC
LIMIT 10このクエリの結果を受け取るターゲットテーブルがあるとします。結果が正しくマージされるように、AggregatingMergeTreeテーブルエンジンと AggregateFunction が使用されている点に注意してください。
CREATE TABLE user_activity
(
    `UserId` String,
    `last_description` AggregateFunction(argMax, String, DateTime64(3, 'UTC')),
    `activity_type` AggregateFunction(argMax, String, DateTime64(3, 'UTC')),
    `last_activity` SimpleAggregateFunction(max, DateTime64(3, 'UTC'))
)
ENGINE = AggregatingMergeTree
ORDER BY UserIdこのテーブルを、badges または comments のいずれかに新しい行が挿入されるたびに更新したい場合、この問題に対する単純なアプローチとしては、前述のユニオン クエリを使って materialized view を作成しようとすることです。
CREATE MATERIALIZED VIEW user_activity_mv TO user_activity AS
SELECT
 UserId,
 argMaxState(description, event_time) AS last_description,
 argMaxState(activity_type, event_time) AS activity_type,
    max(event_time) AS last_activity
FROM
(
    SELECT
 UserId,
 CreationDate AS event_time,
        Text AS description,
        'comment' AS activity_type
    FROM stackoverflow.comments
    UNION ALL
    SELECT
 UserId,
        Date AS event_time,
        Name AS description,
        'badge' AS activity_type
    FROM stackoverflow.badges
)
GROUP BY UserId
ORDER BY last_activity DESC
これは構文的には有効ですが、意図しない結果になります。ビューがトリガーされるのは comments テーブルへの insert の場合だけです。例えば:
INSERT INTO comments VALUES (99999999, 23121, 1, 'The answer is 42', now(), 2936484, 'gingerwizard');

SELECT
 UserId,
 argMaxMerge(last_description) AS description,
 argMaxMerge(activity_type) AS activity_type,
    max(last_activity) AS last_activity
FROM user_activity
WHERE UserId = '2936484'
GROUP BY UserId
┌─UserId──┬─description──────┬─activity_type─┬───────────last_activity─┐
│ 2936484 │ The answer is 42 │ comment │ 2025-04-15 09:56:19.000 │
└─────────┴──────────────────┴───────────────┴─────────────────────────┘
1 row in set. Elapsed: 0.005 sec.badges テーブルへの挿入ではビューがトリガーされないため、user_activity は更新されません:
INSERT INTO badges VALUES (53505058, 2936484, 'gingerwizard', now(), 'Gold', 0);

SELECT
 UserId,
 argMaxMerge(last_description) AS description,
 argMaxMerge(activity_type) AS activity_type,
    max(last_activity) AS last_activity
FROM user_activity
WHERE UserId = '2936484'
GROUP BY UserId;
┌─UserId──┬─description──────┬─activity_type─┬───────────last_activity─┐
│ 2936484 │ The answer is 42 │ comment │ 2025-04-15 09:56:19.000 │
└─────────┴──────────────────┴───────────────┴─────────────────────────┘
1 row in set. Elapsed: 0.005 sec.これを解決するには、各SELECTステートメントごとにmaterialized viewを作成するだけです:
DROP TABLE user_activity_mv;
TRUNCATE TABLE user_activity;

CREATE MATERIALIZED VIEW comment_activity_mv TO user_activity AS
SELECT
 UserId,
 argMaxState(Text, CreationDate) AS last_description,
 argMaxState('comment', CreationDate) AS activity_type,
    max(CreationDate) AS last_activity
FROM stackoverflow.comments
GROUP BY UserId;

CREATE MATERIALIZED VIEW badges_activity_mv TO user_activity AS
SELECT
 UserId,
 argMaxState(Name, Date) AS last_description,
 argMaxState('badge', Date) AS activity_type,
    max(Date) AS last_activity
FROM stackoverflow.badges
GROUP BY UserId;これで、どちらのテーブルに挿入しても正しい結果が得られます。たとえば、comments テーブルに挿入する場合は次のとおりです。
INSERT INTO comments VALUES (99999999, 23121, 1, 'The answer is 42', now(), 2936484, 'gingerwizard');

SELECT
 UserId,
 argMaxMerge(last_description) AS description,
 argMaxMerge(activity_type) AS activity_type,
    max(last_activity) AS last_activity
FROM user_activity
WHERE UserId = '2936484'
GROUP BY UserId;
┌─UserId──┬─description──────┬─activity_type─┬───────────last_activity─┐
│ 2936484 │ The answer is 42 │ comment │ 2025-04-15 10:18:47.000 │
└─────────┴──────────────────┴───────────────┴─────────────────────────┘
1 row in set. Elapsed: 0.006 sec.同様に、badgesテーブルへの挿入はuser_activityテーブルに反映されます。
INSERT INTO badges VALUES (53505058, 2936484, 'gingerwizard', now(), 'Gold', 0);

SELECT
 UserId,
 argMaxMerge(last_description) AS description,
 argMaxMerge(activity_type) AS activity_type,
    max(last_activity) AS last_activity
FROM user_activity
WHERE UserId = '2936484'
GROUP BY UserId
┌─UserId──┬─description──┬─activity_type─┬───────────last_activity─┐
│ 2936484 │ gingerwizard │ badge │ 2025-04-15 10:20:18.000 │
└─────────┴──────────────┴───────────────┴─────────────────────────┘
1 row in set. Elapsed: 0.006 sec.並列処理と順次処理
前の例で示したように、1 つのテーブルを複数の Materialized View のソースとして使用できます。これらの実行順序は、設定 parallel_view_processing によって決まります。
デフォルトでは、この設定は 0 (false) であり、Materialized View は uuid の順に順次実行されます。
たとえば、次の source テーブルと 3 つの Materialized View を考えてみましょう。各 View は行を target テーブルに送信します。
CREATE TABLE source
(
    `message` String
)
ENGINE = MergeTree
ORDER BY tuple();

CREATE TABLE target
(
    `message` String,
    `from` String,
    `now` DateTime64(9),
    `sleep` UInt8
)
ENGINE = MergeTree
ORDER BY tuple();

CREATE MATERIALIZED VIEW mv_2 TO target
AS SELECT
    message,
    'mv2' AS from,
    now64(9) as now,
    sleep(1) as sleep
FROM source;

CREATE MATERIALIZED VIEW mv_3 TO target
AS SELECT
    message,
    'mv3' AS from,
    now64(9) as now,
    sleep(1) as sleep
FROM source;

CREATE MATERIALIZED VIEW mv_1 TO target
AS SELECT
    message,
    'mv1' AS from,
    now64(9) as now,
    sleep(1) as sleep
FROM source;各ビューは、それぞれの名前と挿入時刻を含めたうえで、target テーブルに行を挿入する前に 1 秒待機する点に注目してください。
source テーブルに 1 行挿入するのに約 3 秒かかり、各ビューは順番に実行されます。
INSERT INTO source VALUES ('test')1 row in set. Elapsed: 3.786 sec.SELECT を使って、各行が到着していることを確認できます:
SELECT
    message,
    from,
    now
FROM target
ORDER BY now ASC
┌─message─┬─from─┬───────────────────────────now─┐
│ test │ mv3 │ 2025-04-15 14:52:01.306162309 │
│ test │ mv1 │ 2025-04-15 14:52:02.307693521 │
│ test │ mv2 │ 2025-04-15 14:52:03.309250283 │
└─────────┴──────┴───────────────────────────────┘
3 rows in set. Elapsed: 0.015 sec.これはビューのuuidに対応しています:
SELECT
    name,
 uuid
FROM system.tables
WHERE name IN ('mv_1', 'mv_2', 'mv_3')
ORDER BY uuid ASC
┌─name─┬─uuid─────────────────────────────────┐
│ mv_3 │ ba5e36d0-fa9e-4fe8-8f8c-bc4f72324111 │
│ mv_1 │ b961c3ac-5a0e-4117-ab71-baa585824d43 │
│ mv_2 │ e611cc31-70e5-499b-adcc-53fb12b109f5 │
└──────┴──────────────────────────────────────┘
3 rows in set. Elapsed: 0.004 sec.逆に、parallel_view_processing=1 を有効にして1行を insert した場合に何が起こるかを見てみましょう。これを有効にすると、ビューは並列に実行されるため、行がターゲットテーブルに到達する順序は保証されません。
TRUNCATE target;
SET parallel_view_processing = 1;

INSERT INTO source VALUES ('test');
1 row in set. Elapsed: 1.588 sec.SELECT
message,
from,
now
FROM target
ORDER BY now ASC┌─message─┬─from─┬───────────────────────────now─┐
│ test │ mv3 │ 2025-04-15 19:47:32.242937372 │
│ test │ mv1 │ 2025-04-15 19:47:32.243058183 │
│ test │ mv2 │ 2025-04-15 19:47:32.337921800 │
└─────────┴──────┴───────────────────────────────┘
3 rows in set. Elapsed: 0.004 sec.各ビューから到着する行の順序はここでは同じですが、これは保証されるものではありません。各行のinsert timeが近いことからも、そのことがわかります。あわせて、insert性能が向上している点にも注目してください。
並列処理を使用するタイミング
parallel_view_processing=1 を有効にすると、上で示したように insert スループットを大幅に向上できる場合があります。特に、1 つのテーブルに複数の Materialized Views が関連付けられている場合に効果的です。ただし、そのトレードオフを理解しておくことが重要です。
- insert 負荷の増加: すべての Materialized Views が同時に実行されるため、CPU 使用率とメモリ使用量が増加します。各 view で重い計算や JOIN を実行する場合、システムに過負荷がかかるおそれがあります。
- 厳密な実行順序が必要: まれなワークフローでは、view の実行順序が重要になることがあります (たとえば、連鎖した依存関係がある場合) 。このような場合、並列実行によって state の不整合や race condition が発生する可能性があります。これを回避できるよう設計することも可能ですが、そのような構成は脆弱で、将来のバージョンで破綻するおそれがあります。
一般に、次の場合は parallel_view_processing=1 を有効にしてください。
- 複数の独立した Materialized Views がある
- insert パフォーマンスを最大化したい
- 同時実行の view 実行にシステムが耐えられることを把握している
次の場合は無効のままにしてください。
- Materialized Views が相互に依存している
- 予測可能で順序どおりの実行が必要
- insert の挙動を debugging または監査しており、決定論的なリプレイが必要
materialized view と共通テーブル式 (CTE)
非再帰の共通テーブル式 (CTE) は、materialized view でサポートされています。
次の例では、投稿タイプごとの日次アクティビティを計算します。
CREATE TABLE daily_post_activity
(
    Day Date,
 PostType String,
 PostsCreated SimpleAggregateFunction(sum, UInt64),
 AvgScore AggregateFunction(avg, Int32),
 TotalViews SimpleAggregateFunction(sum, UInt64)
)
ENGINE = AggregatingMergeTree
ORDER BY (Day, PostType);

CREATE MATERIALIZED VIEW daily_post_activity_mv TO daily_post_activity AS
WITH filtered_posts AS (
    SELECT
 toDate(CreationDate) AS Day,
 PostTypeId,
 Score,
 ViewCount
    FROM posts
    WHERE Score > 0 AND PostTypeId IN (1, 2)  -- 質問または回答
)
SELECT
    Day,
    CASE PostTypeId
        WHEN 1 THEN 'Question'
        WHEN 2 THEN 'Answer'
    END AS PostType,
    count() AS PostsCreated,
    avgState(Score) AS AvgScore,
    sum(ViewCount) AS TotalViews
FROM filtered_posts
GROUP BY Day, PostTypeId;
ここではCTEは厳密には不要ですが、例として示すために、このビューは期待どおりに動作します:
INSERT INTO posts
SELECT *
FROM s3Cluster('default', 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/stackoverflow/parquet/posts/by_month/*.parquet')
SELECT
Day,
PostType,
avgMerge(AvgScore) AS AvgScore,
sum(PostsCreated) AS PostsCreated,
sum(TotalViews) AS TotalViews
FROM daily_post_activity
GROUP BY
Day,
PostType
ORDER BY Day DESC
LIMIT 10┌────────Day─┬─PostType─┬───────────AvgScore─┬─PostsCreated─┬─TotalViews─┐
│ 2024-03-31 │ Question │ 1.3317757009345794 │ 214 │ 9728 │
│ 2024-03-31 │ Answer │ 1.4747191011235956 │ 356 │ 0 │
│ 2024-03-30 │ Answer │ 1.4587912087912087 │ 364 │ 0 │
│ 2024-03-30 │ Question │ 1.2748815165876777 │ 211 │ 9606 │
│ 2024-03-29 │ Question │ 1.2641509433962264 │ 318 │ 14552 │
│ 2024-03-29 │ Answer │ 1.4706927175843694 │ 563 │ 0 │
│ 2024-03-28 │ Answer │ 1.601637107776262 │ 733 │ 0 │
│ 2024-03-28 │ Question │ 1.3530864197530865 │ 405 │ 24564 │
│ 2024-03-27 │ Question │ 1.3225806451612903 │ 434 │ 21346 │
│ 2024-03-27 │ Answer │ 1.4907539118065434 │ 703 │ 0 │
└────────────┴──────────┴────────────────────┴──────────────┴────────────┘
10 rows in set. Elapsed: 0.013 sec. Processed 11.45 thousand rows, 663.87 KB (866.53 thousand rows/s., 50.26 MB/s.)
Peak memory usage: 989.53 KiB.ClickHouse では、CTE はインライン展開されます。つまり、最適化時にクエリ内へ実質的にコピー&ペーストされ、materialize されません。これは次のことを意味します。
- CTE がソーステーブル (つまり、materialized view がアタッチされているテーブル) とは別のテーブルを参照しており、
JOINまたはIN句で使われている場合、それはトリガーではなく、サブクエリまたは join として動作します。 - materialized view 自体は引き続きメインのソーステーブルへの INSERT でのみトリガーされますが、CTE は INSERT のたびに再実行されるため、特に参照先のテーブルが大きい場合は不要なオーバーヘッドが発生する可能性があります。
たとえば、
WITH recent_users AS (
  SELECT Id FROM stackoverflow.users WHERE CreationDate > now() - INTERVAL 7 DAY
)
SELECT * FROM stackoverflow.posts WHERE OwnerUserId IN (SELECT Id FROM recent_users)
この場合、users CTE は posts への挿入のたびに再評価され、新しい users が挿入されても materialized view は更新されません。更新されるのは、posts に挿入があったときだけです。
一般に、CTE は、materialized view が関連付けられている同じソーステーブルに対して動作するロジックに使用するか、参照する table が小さく、パフォーマンスのボトルネックになる可能性が低いことを確認してください。あるいは、JOIN を使用した Materialized Views と同じ最適化を検討してください。